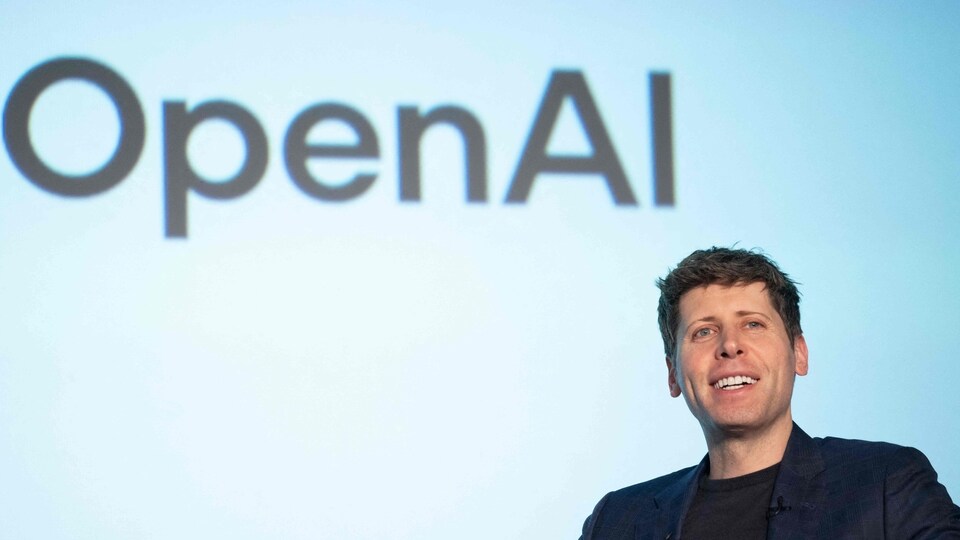
Direktor američke kompanije OpenAI, Sem Altman, izjavio je danas da svijet ima „pravo da se plaši“, ali da „treba da vjeruje“ kompanijama koje se bave vještačkom inteligencijom (AI) da „rade pravu stvar“ kada je u pitanju bezbjednost i razvoj AI.
Svijet bi trebalo da vjeruje da ćemo učiniti pravu stvar, jer je to prava stvar i osjećamo veličinu ovoga, rekao je Altman na konferenciji u San Francisku koju je organizovala softverska firma Sejlsfors, prenosi BBC.
On je kazao da ljudi imaju opravdan strah u vezi sa vještačkom inteligencijom, jer su se mogućnosti alata brzo razvijale.
– Ne treba nam toliko mašte kao nekada da bismo zamislili kako bi ovo moglo poći po zlu. Mislim da je svijet u pravu što se ovoga plaši – kazao je Altman.
Ovo je prvo Altmanovo javno obraćanje od kada je prošle nedjelje postala viralna objava istraživača koji je napustio firmu za vještačku inteligenciju Antropik (Anthropic), navodeći da bi AI mogla da ubije sve ljude do kraja decenije ukoliko se ne kontroliše.
Nekoliko drugih rukovodilaca i stručnjaka za vještačku inteligenciju odgovorilo je da se slažu sa tom procjenom, iako nisu objasnili kako su došli do svojih zaključaka ili kako tačno vještačka inteligencija može da postigne tako nešto.
Altman je na konferenciji rekao i da smatra da su kompanije za vještačku inteligenciju, poput njegove, sposobne da se u suštini same regulišu.
– Uradićemo to kako treba, čvrsto sam uvjeren u sposobnost naše kompanije i industrije da ovo urade bezbjedno – rekao je Altman, koji je dodao da je siguran da će “usklađenost i bezbjednost biti daleko ispred mogućnosti”, kao i da će, ako to ne budu mogli, “usporiti ili se zaustaviti”.
Nakon Altmanovih komentara, šef Mete, Mark Zakerberg, napisao je na platformi X da svaka laboratorija za vještačku inteligenciju ima sposobnost i podsticaj “da preduzme sopstvene akcije” u cilju kreiranja alata i modela vještačke inteligencije dizajniranih tako da osiguraju bezbjednost.
Last month I wrote about how we can build a positive and safe future for everyone: https://t.co/eoLGVY8yad
Every lab has the responsibility and incentive to move at the pace required to train its models safely, and the ability to take its own actions to ensure that happens.
The reality is:
– People won’t want to use agents that are misaligned with them and that don’t do what they ask, so labs have a strong natural incentive to make their models more aligned.
There is a lot of debate about slowing progress on capabilities until alignment catches up. My view is that trust and alignment are quickly becoming the most important capabilities that will differentiate agents and models. Any lab that doesn’t focus on alignment will fall behind.
– Labs face significant liability if their models cause harm, so they have a strong incentive to prevent this as well.
Meta delayed shipping Muse for several months to focus on safety and security. We didn’t call for everyone else to do this before we would. We just did it as part of our day-to-day work because it was clearly the right thing for people and for us. I’m proud of the security foundations we’ve built.
– Engaging independent evaluators and advisors is industry best practice. MSL already does this today in several areas because it helps produce better work. Other labs can just do this too. In general, it would be helpful for there to be a larger and more diverse ecosystem of evaluators.
– Committing the significant majority of compute towards serving people rather than racing towards recursive self-improvement is one of the best ways to ensure we develop this technology safely. Meta has made this commitment and other labs can do this as well.
I believe the key to building a positive future for everyone is maintaining the right balance of power. This is within our power to do.
— Mark Zuckerberg (@finkd) September 15, 2026
– Svaka laboratorija koja se ne fokusira na usklađivanje, zaostaće. Laboratorije se suočavaju sa značajnom odgovornošću ako njihovi modeli nanesu štetu, tako da imaju snažan podsticaj da to spriječe – kazao je Zakerberg.
(Tanjug)